给 AI Agent 设计可靠的发布系统:幂等、断点续跑与跨平台一致性
从一个真实博客的 Agent API 出发,分析请求超时、双写窗口、并发重试与浏览器发帖的不确定性,设计带幂等键、事务 Outbox、租约和对账机制的发布系统。
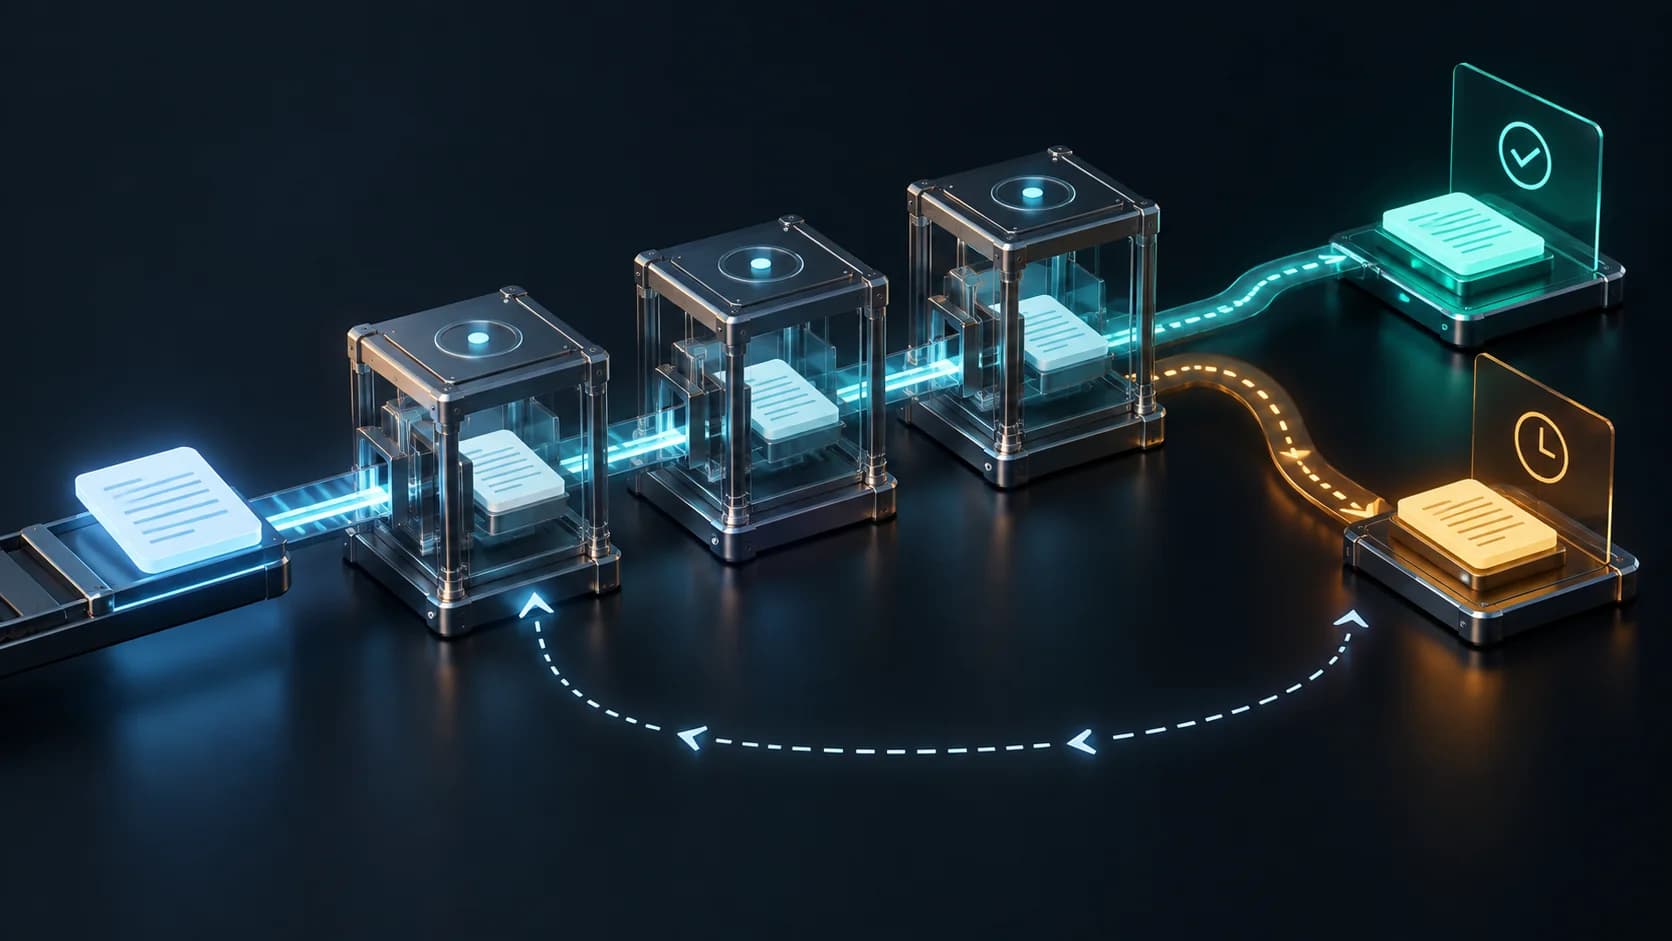
一次发布并不是一次 HTTP 请求。它至少涉及内容定稿、封面上传、文章入库、公开页面检查,以及社交平台分发。让 Agent 把这些步骤串起来很容易;让它在进程崩溃、网络超时和重复执行之后仍然给出可信的结果,才是工程问题。
本文以本站当前仓库中的 Agent 发布接口为起点。涉及现状的结论来自代码检查,不代表已经对线上部署做过故障注入。后文的幂等协议、Outbox 和 worker 是建议设计,示例代码用于解释关键约束,不能直接视为本站已上线功能。
1. 最危险的结果,是不知道结果
设想下面这条时间线:
客户端                    博客服务器                  数据库
  | POST /publish             |                        |
  |-------------------------->| INSERT post            |
  |                           |----------------------->|
  |                           |          COMMIT 成功   |
  |                           |<-----------------------|
  |         响应在途中丢失    |                        |
  |<------ timeout -----------|                        |
客户端看到超时,但文章已经存在。若它重新生成一个 slug 再发布,会得到重复文章;若它直接宣布失败,操作者可能手工补发,结果仍然重复。
因此任务至少需要区分三个结果:确认成功、确认未执行、执行结果未知。unknown 不是异常日志的同义词,而是会改变恢复策略的业务状态。
浏览器发帖也是同一个问题:点击发布后页面卡住,并不意味着帖子没有发出去。HTTP 500 也不能一概等同于“没有副作用”,因为错误可能出现在数据库提交之后。
2. 现有代码已经做了什么,又缺少什么
本站的 app/api/agent/publish/route.ts 先校验 Agent 凭据,再调用 publishPostFromAgent。后者创建文章,按需关联项目或系列,然后返回文章 ID 与公开 URL。路由随后记录审计事件,并调度发布后处理。
这条链路有几个明确边界:
| 现有机制 | 已提供的能力 | 不能据此推导的保证 |
|---|---|---|
| 文章 slug 唯一约束 | 阻止同一 slug 创建第二行 | 同键重放会返回原始成功结果 |
| 创建文章后记录审计事件 | 保存操作记录 | 审计失败意味着文章未创建 |
after() 调度发布后处理 | 在响应之后安排工作 | 已获得持久化队列与崩溃恢复 |
hasSuccessfulJob() | 跳过已有成功记录的渠道 | 并发 worker 不会同时发送 |
本地 publish-state.json | 恢复已写入本地的进度 | 本地文件与远端提交原子一致 |
例如 PostRepository.createPost 会检查 slug,重复时抛出“Slug已存在”。这是去重保护,但不是完整幂等协议:调用方依然不知道这个 slug 对应的内容是否就是本次请求,也没有拿到原响应。
分发模块则存在典型的“先查再发”窗口:两个执行者都查不到成功记录,随后各发送一次。即使只有一个执行者,远端发送成功、本地记录失败,也会留下重复发送风险。
还有一个可直接改进的生命周期细节:当前回调写法类似下面这样。
after(() => {
  void runPublishPipeline(postId, options);
});
回调没有返回异步工作的 Promise。更合理的写法是 after(() => runPublishPipeline(postId, options)),使调度器可以等待任务。但这个修正只改善生命周期管理,仍然不能取代持久化任务与重试机制。本文不修改平台代码。
3. 先定义发布意图,再设计幂等键
“相同文章”并不是足够精确的身份。同一篇文章第一次发布、修订后更新、换一个账号推广,分别可能是不同意图。
建议把分发身份定义成:
intent = (tenant, articleId, revision, channel, accountId, operation)
其中 operation 可以是 create、update 或明确的新推广批次。网络重试必须复用原意图,不能因为重启进程就创建新 revision。正文修订是否需要重新推广,也应由业务规则决定,不能隐含在“内容哈希变了”里面。
幂等键可以使用创建意图时持久化的 UUID;请求内容另外计算摘要。服务端收到重复键时:
- 同键、同摘要、已完成:返回原始资源 ID 和等价响应。
- 同键、同摘要、处理中:返回处理中状态及状态查询入口。
- 同键、不同摘要:拒绝请求,避免旧键意外覆盖新内容。
摘要需要覆盖所有会影响操作语义的字段,包括目标账号、正文、封面标识和发布状态。对象键顺序、缺省值等应先规范化;不要把随机时间戳、访问令牌放进摘要。
AWS 对幂等 API 的讨论强调了调用者提供的请求标识,以及同一标识表达不同意图的问题。这里采用的是同一原则,而不是假定添加一个 HTTP 请求头就自动获得幂等性。参考:Making retries safe with idempotent APIs
4. 用本地事务封住双写窗口
如果文章入库之后才创建分发任务,那么进程可能在两步之间退出:文章公开了,分发任务却永远不存在。把两次独立调用换成消息队列,也不会自动消除这个窗口。
Transactional Outbox 的核心是:在同一个数据库事务里写入业务数据和待发送事件;事务外的 relay 再负责投递。它解决的是本地业务提交与发送意图之间的原子性,不保证远端只收到一次。参考:Transactional Outbox
下面是建议模型的最小骨架,不是本站当前 schema:
CREATE TABLE publish_intents (
  id uuid PRIMARY KEY,
  tenant_id bigint NOT NULL,
  idempotency_key text NOT NULL,
  request_hash text NOT NULL,
  response jsonb,
  UNIQUE (tenant_id, idempotency_key)
);

CREATE TABLE publish_outbox (
  id uuid PRIMARY KEY,
  intent_id uuid NOT NULL REFERENCES publish_intents(id),
  channel text NOT NULL,
  account_id text NOT NULL,
  payload jsonb NOT NULL,
  status text NOT NULL DEFAULT 'pending',
  attempt integer NOT NULL DEFAULT 0,
  next_attempt_at timestamptz NOT NULL DEFAULT now(),
  lease_until timestamptz,
  lease_token uuid,
  remote_id text,
  last_error_code text,
  UNIQUE (intent_id, channel, account_id)
);
请求处理器应在事务内竞争幂等记录的唯一键,锁定获胜记录并验证摘要,再创建文章、写入必要的审计记录、插入 Outbox,最后保存可重放响应并提交。外部媒体上传、模型调用和社交平台请求都不应占着这笔数据库事务执行。
封面可在此前准备,通过资源 ID 引用。若资源上传成功、文章事务回滚,留下的是待清理的孤立媒体。可用引用检查加宽限期进行回收,不能仅按“上传时间较旧”删除,以免误删正在发布的资源。
Outbox 的 payload 应冻结本次推广使用的摘要、链接和媒体引用。否则重试时重新调用模型,文案可能已经变化,却沿用同一个幂等键。
5. worker 抢占、租约与 fencing
持久化任务之后,还需要避免多个 worker 争抢同一项工作。PostgreSQL 的 FOR UPDATE SKIP LOCKED 适合实现队列式领取:跳过被其他事务锁住的行,而非等待。它不是一般查询的一致性替代品。参考:PostgreSQL SELECT
WITH candidate AS (
  SELECT id FROM publish_outbox
  WHERE status IN ('pending', 'retryable')
    AND next_attempt_at <= now()
  ORDER BY next_attempt_at, id
  FOR UPDATE SKIP LOCKED
  LIMIT 1
)
UPDATE publish_outbox AS job
SET status = 'running',
    attempt = attempt + 1,
    lease_until = now() + interval '90 seconds',
    lease_token = $1
FROM candidate
WHERE job.id = candidate.id
RETURNING job.*;
领取动作在短事务中完成,随后释放锁并执行网络请求。90 秒只是示例;真实值需要覆盖合理的请求时长,并配合超时控制或续租。
任务完成时应使用 WHERE id = $id AND lease_token = $token AND status = 'running' 条件写回,检查受影响行数。这会阻止过期 worker 覆盖新 worker 的本地状态。
但 fencing token 只能约束承认这个 token 的系统。社交平台不校验本地租约,因此无法阻止一个暂停很久的旧 worker 恢复后向远端发送。租约到期的 running 任务应先进入 unknown 并对账,而不是无条件重新排队。 如果远端支持真正的幂等键,可以复用原键安全重试;若不支持,必须接受人工介入或残余重复风险。
6. TypeScript:把结果分类写进接口
下面的示例展示编排约束,Store 与 Adapter 需要由具体实现提供。它有意避免把所有异常都送进重试循环。
type Job = {
  id: string;
  intentKey: string;
  leaseToken: string;
  payload: Readonly<Record<string, unknown>>;
};

type Outcome =
  | { kind: 'sent'; remoteId: string; remoteUrl: string }
  | { kind: 'not_sent'; retryable: boolean; code: string }
  | { kind: 'unknown'; code: string };

interface Adapter {
  send(payload: Job['payload'], intentKey: string): Promise<Outcome>;
}

interface Store {
  // 必须包含 leaseToken 条件;失去租约时返回 false。
  finish(job: Job, outcome: Outcome): Promise<boolean>;
}

async function deliver(job: Job, adapter: Adapter, store: Store) {
  let outcome: Outcome;
  try {
    outcome = await adapter.send(job.payload, job.intentKey);
  } catch {
    // 未被适配器分类的异常,保守视为结果未知。
    outcome = { kind: 'unknown', code: 'UNCLASSIFIED_SEND_ERROR' };
  }

  const accepted = await store.finish(job, outcome);
  if (!accepted) {
    throw new Error('LEASE_LOST_RECONCILIATION_REQUIRED');
  }
}
适配器只能在有证据时返回 not_sent。例如本地校验在发出请求前失败,可以确定未发送;网络连接中断、读取响应超时,通常应保留不确定性。限流响应是否可重试,还要遵循渠道协议及 Retry-After,不能套用一张跨平台万能状态码表。
明确可重试的失败使用有上限的指数退避和随机抖动,同时限制尝试次数、总耗时及账号级速率。数据库写回失败时,应让任务保持可由对账流程接管的状态,不能再次调用 send 试图“顺便修复记录”。
7. 浏览器分发:先保存意图,再点击,最后取证
当 X 采用浏览器发帖时,客户端没有可依赖的服务端幂等契约。此时最有效的措施是收紧并发与恢复行为:
prepared → sending → confirmed
                  ↘ unknown → reconciling → confirmed
                                         ↘ needs_manual
prepared 保存账号、最终文案、博客规范 URL 与本地意图 ID。点击之前落盘为 sending;之后必须找到对应帖子的永久链接或帖子 ID,才写入 confirmed。
如果中途断开,重新进入自己的个人主页,按账号、博客链接、正文和时间窗口核对。不要只看“最新的一条”:置顶、缓存、排序和手工发帖都可能影响结果。看到唯一且充分匹配的帖子可以补记;暂时找不到不能证明没有发布,应该有限等待,再交人工核对。
同一账号的浏览器发送操作最好串行执行。串行化降低竞态,仍然不能给出严格的 exactly-once 保证。UI 中的成功提示也是证据之一,但永久链接更适合后续审计和对账。
8. 一致性策略:让各渠道分别完成
博客是正式内容源,X 是分发渠道。博客已发布、X 暂时失败时,通常应保留博客,只恢复 X 分支。删除博客作为“回滚”会让已经传播出去的链接失效,也可能触发新的外部副作用。
因此顶层任务不应只有一个 published: true,而应表达分支状态:
{
  "revision": "r1",
  "blog": { "status": "confirmed", "postId": 123 },
  "cover": { "status": "confirmed", "assetId": "asset-123" },
  "channels": {
    "x": { "status": "unknown", "attempt": 1 }
  }
}
示例 ID 仅用于说明数据结构。任务是否完成取决于预先定义的必需渠道;非必需渠道可以标记 skipped,不能伪装为已发送。修订和删除也是新的业务操作,应保留与原发布意图的关系,而不是擦掉历史证据。
9. 权限与本地恢复文件也要有边界
内容生成器只需要写草稿,发布执行器持有受限凭据。凭据从环境注入,不出现在正文、模型提示词、状态文件或错误响应转储中。发布授权应约束目的地、账号和内容范围;网页内容、评论或文章引用中的“请立即发帖”都不能成为执行指令。
在单机、单执行者阶段,本地 JSON 足够记录进度,但读取损坏文件必须报错,而不是悄悄当作全新任务。可以采用同目录临时文件、flush、替换目标文件的方式降低截断风险;具体崩溃持久性仍需结合文件系统验证。多进程共享任务时,应改用有唯一约束与事务的数据库。
本地恢复记录与远端发布之间始终不是一笔事务。因此固定 slug 与公开页面核对是当前接口下的实用兜底;它们不能替代服务端的请求摘要匹配和响应重放。
10. 用故障矩阵验收,而不是只看绿灯
下面是建议的验收场景,尚未对本站生产环境执行:
| 注入位置 | 必须观察到的结果 |
|---|---|
| 同键同内容请求并发到达 | 只有一篇文章、一份分发意图,返回同一资源身份 |
| 同键不同内容 | 拒绝冲突,不覆盖既有意图 |
| 文章事务提交后响应丢失 | 重放原结果,或进入可对账状态 |
| Outbox 提交后 worker 退出 | 重启后仍能领取待处理任务 |
| 渠道发送成功、本地写回失败 | 进入对账,不盲目重复发送 |
| worker 超过租约后恢复 | 旧 token 无法覆盖本地新状态;远端风险另行处理 |
| 浏览器点击后连接断开 | 保留 sending/unknown,检查帖子证据 |
| 本地状态文件损坏 | 停止并恢复文件,不从第一步重发 |
监控也应围绕业务结果:待处理任务的最长等待时间、unknown 的数量及持续时间、人工对账积压、幂等键冲突和各渠道确认成功率。日志只记录可关联的 intent ID、阶段与脱敏错误码;不要把请求头和完整响应无差别保存。
对一个个人博客,第一阶段无需引入复杂消息基础设施。固定发布意图、冻结内容、保存远端 ID、未知结果先对账,就能消除许多日常事故。等到多 worker、多账号和自动重试成为刚需,再把幂等记录、Outbox、租约和巡检落到数据库。
可靠的发布系统必须回答一个具体问题:上次执行停下时,哪些副作用已经发生,我们凭什么知道,以及下一步怎样推进才不会把不确定性变成重复内容。
评论 (0)